Hầu hết các ứng dụng AI khi vừa ra mắt đều gặp chung một bài toán: chi phí token tăng nhanh hơn tốc độ tăng trưởng doanh thu. Phần lớn chi phí này đến từ việc người dùng liên tục hỏi những câu có cùng ý nghĩa, nhưng mô hình vẫn phải tính toán lại từ đầu chỉ vì câu chữ khác nhau vài từ.
Nếu chỉ dùng bộ nhớ đệm truyền thống như Redis với cơ chế so sánh chuỗi chính xác (Exact Match), tỷ lệ trúng cache (Cache Hit) gần như bằng không. Dưới đây là cách triển khai Semantic Cache (Cache theo ngữ nghĩa) bằng Vector Database giúp hệ thống phản hồi tức thì với chi phí gần như bằng 0.
1. Bản chất: Exact Cache vs. Semantic Cache khác nhau ở đâu?
Bộ đệm thông thường chỉ hoạt động khi hai chuỗi ký tự khớp nhau 100%:
- Exact Match Cache: Khách A hỏi
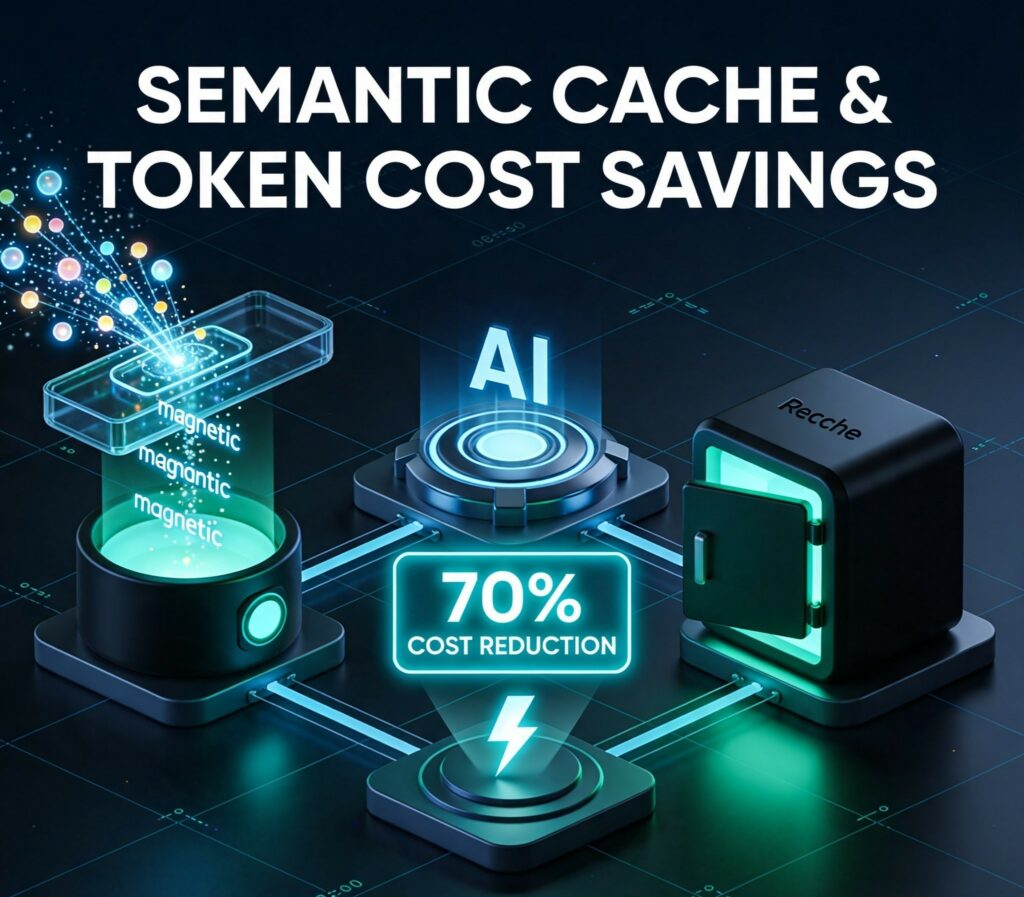
"Chính sách đổi trả ra sao?"-> Cache lưu câu trả lời. Nhưng khi khách B hỏi"Shop cho đổi hàng trong mấy ngày?"-> Trượt cache (Cache Miss) và hệ thống lại tốn tiền gọi API mô hình lớn. - Semantic Cache: Biến câu hỏi thành vector biểu diễn ngữ nghĩa (Embedding). Khi khách B hỏi, hệ thống tính toán khoảng cách cosine giữa hai vector. Nếu độ tương đồng vượt ngưỡng (ví dụ > 0.92), hệ thống trả ngay câu trả lời đã lưu từ khách A trong vài mili-giây mà không tốn một token LLM nào.
2. Ba bước triển khai Semantic Cache với Vector DB và Redis
Bước 1: Tạo Embedding siêu nhẹ ở tầng Gateway
Đừng dùng các model embedding quá cồng kềnh gây tăng độ trễ. Hãy chọn các mô hình nhỏ gọn chạy ở Edge hoặc API giá rẻ (như text-embedding-3-small):
# Tạo vector ngữ nghĩa cho câu hỏi đầu vào
query_vector = get_embedding(user_prompt)
Bước 2: Truy vấn độ tương đồng (Cosine Similarity Search)
Tìm kiếm trong index vector câu hỏi tương đồng nhất đã từng xuất hiện:
# Tìm kiếm câu hỏi gần nhất trong bán kính tương đồng
match = vector_db.similarity_search(query_vector, threshold=0.92, limit=1)

if match:
    # Cache HIT: Trả về câu trả lời đã cache sẵn
    return match.cached_response
Bước 3: Cơ chế Ghi đệm bất đồng bộ (Async Write-back)
Nếu Cache Miss, gửi request tới mô hình LLM chính để sinh câu trả lời. Ngay sau khi nhận kết quả, ném tác vụ lưu cặp (query_vector, answer) vào hàng đợi ngầm (Queue) để không làm tăng thời gian chờ của người dùng.
3. Ba cạm bẫy cần tránh khi dùng Semantic Cache
- Ngưỡng tương đồng (Threshold) quá thấp: Đặt ngưỡng dưới 0.85 sẽ dẫn đến tình trạng “râu ông nọ cắm cằm bà kia”, trả nhầm câu trả lời của sản phẩm này cho sản phẩm khác. Ngưỡng an toàn thực tế thường dao động từ 0.90 đến 0.94.
- Cache cả dữ liệu mang tính thời gian thực: Tuyệt đối không cache các câu hỏi phụ thuộc vào trạng thái động (như: “Đơn hàng #123 của tôi đến đâu rồi?” hay “Số dư tài khoản”). Cần có bộ lọc phân loại ý định (Intent Classifier) trước khi quyết định đưa vào semantic cache.
- Chiến lược hết hạn (TTL & Invalidation): Khi chính sách giá hoặc thông tin sản phẩm thay đổi, phải có script tự động xóa sạch các vector liên quan trong database để tránh AI trả về thông tin lỗi thời.
Lời kết
Tối ưu chi phí cho ứng dụng AI không nhất thiết phải hạ cấp xuống dùng các mô hình nhỏ hơn, kém thông minh hơn. Bằng cách chặn đứng các câu hỏi lặp lại bằng một lớp Semantic Cache thông minh, bạn vừa giảm được áp lực tài chính, vừa mang lại tốc độ phản hồi tính bằng mili-giây cho người dùng.