Tuần trước, một tính năng mới cho phép người dùng đăng tải hợp đồng 30 trang để AI tóm tắt đã khiến cụm API server của chúng tôi dính sự cố nghẽn mạng nghiêm trọng. Toàn bộ người dùng khác liên tục gặp lỗi 504 Gateway Timeout.
Nguyên nhân không nằm ở mô hình AI, mà nằm ở việc chúng tôi đã bắt kết nối HTTP phải chờ đợi AI trả về kết quả.
1. Diễn biến sự cố và lối thoát duy nhất
Khi 20 người dùng cùng lúc gửi file, 20 HTTP Connection bị giữ chân trong 45 giây để chờ LLM phản hồi. Bộ nhớ RAM cạn kiệt, các request đơn giản như “đăng nhập” hay “xem hồ sơ” bị đẩy vào hàng đợi và hết thời gian chờ (timeout).
Lối thoát kỹ thuật duy nhất là: Xóa bỏ hoàn toàn việc xử lý AI trực tiếp trong luồng request-response.
[Trước sự cố - Đồng bộ (Synchronous)]
Client ──► (Gửi File) ──► HTTP Server ──► [Chờ LLM 45s...] ──► Client Timeout!

[Sau khi sửa - Bất đồng bộ (Asynchronous)]
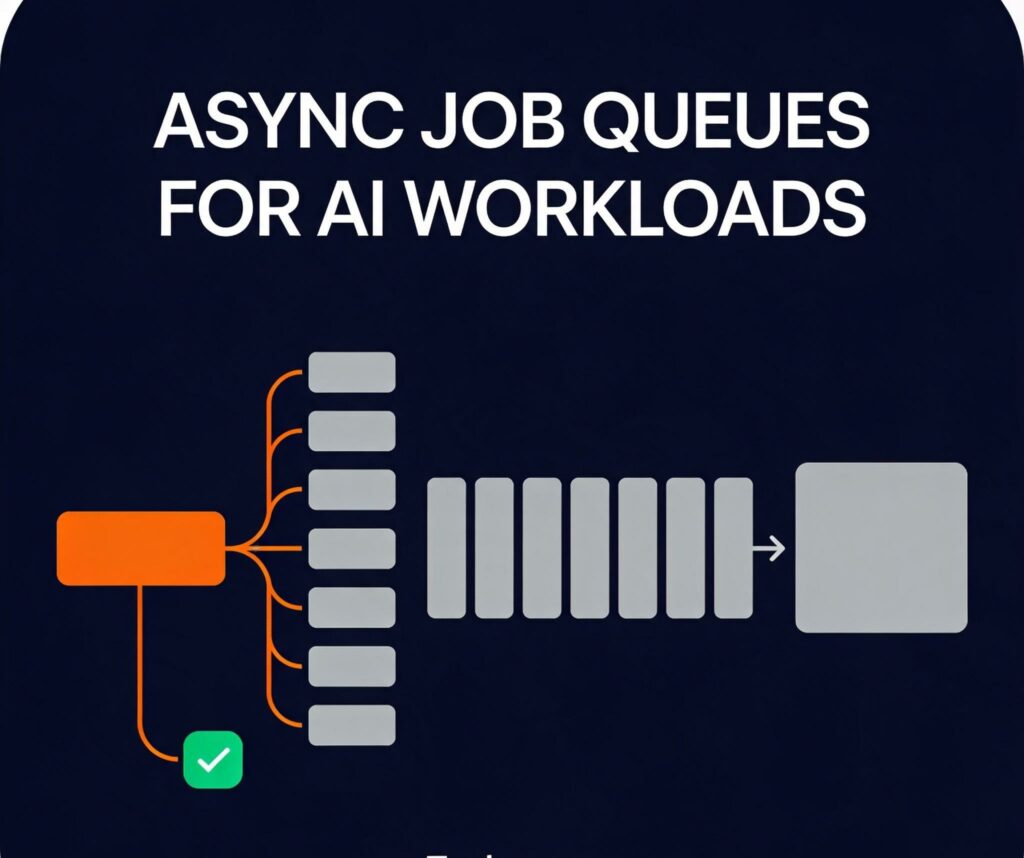
1. Client ──► (Gửi File) ──► HTTP Server ──► Đẩy vào Redis Queue ──► Trả về { jobId } (< 50ms)
2. Background Worker ◄── Lấy Job từ Queue ──► Gọi LLM ──► Lưu kết quả vào DB
3. Client ──► Polling / Webhook ──► Nhận kết quả khi thành công
2. Tái cấu trúc mã nguồn: Chuyển sang BullMQ & Redis Streams
Thay vì thực thi trực tiếp, Controller hiện tại chỉ đóng vai trò “nhận vé và phát mã số chờ”:
TypeScript
// 1. Controller tiếp nhận request cực nhanh (< 50ms)
export async function handleContractAnalysis(req: Request, res: Response) {
  const { documentUrl, userId } = req.body;

  // Thêm việc vào hàng đợi Redis
  const job = await aiQueue.add("analyze-contract", {
    documentUrl,
    userId,
    createdAt: new Date(),
  }, { attempts: 3, backoff: { type: "exponential", delay: 1000 } });

  // Trả về ngay lập tức mã Job ID
  return res.status(202).json({
    status: "PROCESSING",
    jobId: job.id,
    checkStatusUrl: `/api/v1/jobs/${job.id}`
  });
}
Phần việc nặng nhọc được chuyển hoàn toàn sang cho một tiến trình Worker chạy độc lập:
TypeScript
// 2. Worker xử lý ngầm biệt lập
const aiWorker = new Worker("ai-processing-queue", async (job) => {
  const { documentUrl, userId } = job.data;

  // Gọi AI Model (không ảnh hưởng tới Web Server)
  const summary = await callLLMModel(documentUrl);

  await saveResultToDatabase(job.id, userId, summary);
  return { completed: true };
}, { concurrency: 5 }); // Giới hạn tối đa 5 tác vụ AI chạy song song
Bài học rút ra cho hệ thống Production
- Luôn đặt giới hạn Concurrency: Khống chế số lượng Worker chạy cùng lúc để tránh bị nhà cung cấp OpenAI/Anthropic khóa IP do vượt giới hạn Rate Limit (RPM/TPM).
- Quản lý tiến độ (Progress Tracking): Cập nhật
%hoàn thành vào Redis để giao diện phía người dùng có thanh Progress Bar mượt mà thay vì màn hình xoay tròn vô tận.
Đưa các tác vụ nặng ra khỏi luồng HTTP chính là bước ngoặt giúp hệ thống duy trì độ phản hồi sub-100ms cho mọi người dùng.