Khi một câu truy vấn SQL chạy chậm, phản xạ quen thuộc của nhiều developer là kiểm tra mệnh đề WHERE và tiện tay đánh ngay một cái B-Tree Index lên các cột xuất hiện trong đó.
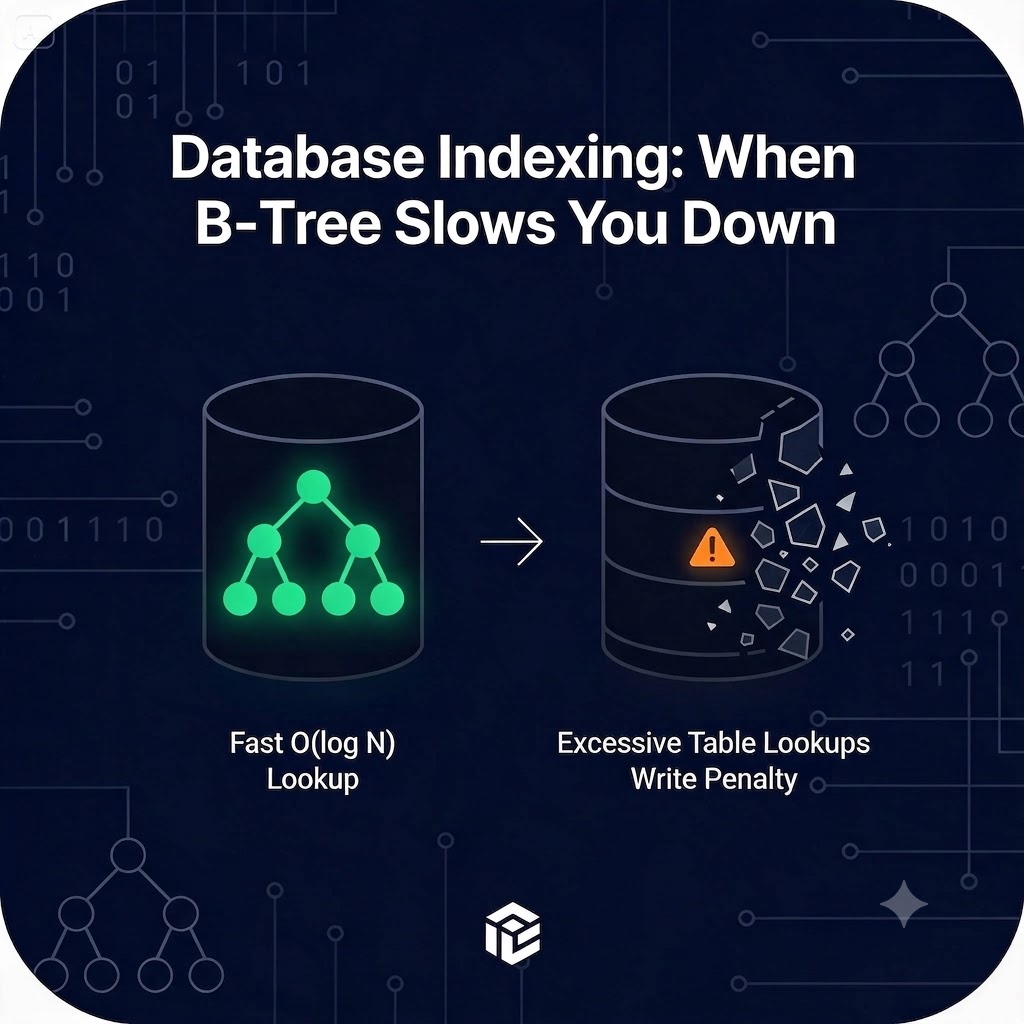
Index đúng là cứu cánh giúp giảm thời gian quét dữ liệu từ $O(N)$ (Full Table Scan) xuống $O(\log N)$. Tuy nhiên, Index không phải lúc nào cũng miễn phí, và không phải lúc nào database engine cũng chọn dùng index bạn đã tạo. Trong nhiều trường hợp, việc lạm dụng hoặc đánh index sai cách không những không tăng tốc độ mà còn biến câu query thành thảm họa hiệu năng.
Dưới đây là 3 trường hợp điển hình khiến việc đánh B-Tree Index phản tác dụng:
1. Cột có độ biến thiên thấp (Low Cardinality)
Cardinality đại diện cho số lượng giá trị phân biệt (unique values) trong một cột so với tổng số dòng.
- Ví dụ: Cột
status(ACTIVE,INACTIVE),gender(M,F), hoặcis_deleted(true,false). - Tại sao Index lại vô dụng?
- Nếu bảng có 1.000.000 bản ghi và 90% số dòng có
status = 'ACTIVE':- Khi bạn query
WHERE status = 'ACTIVE', nếu dùng Index, database phải duyệt cây B-Tree để lấy danh sách con trỏ (pointer), sau đó quay ngược lại bảng chính (Random I/O) để nhặt từng dòng (quá trình này gọi là Table Lookup / Bookmark Lookup). - Bộ tối ưu truy vấn (Query Optimizer) sẽ nhận ra chi phí nhảy qua nhảy lại bằng Random I/O tốn kém hơn nhiều so với việc đọc tuần tự một mạch từ đầu đến cuối ổ đĩa (Sequential Scan). Kết quả: Database bỏ qua Index bạn vừa tạo.
- Khi bạn query
- Giải pháp: Nếu cần đánh index cho các cột cờ (flag), hãy dùng Partial Index / Filtered Index (chỉ đánh index cho trạng thái hiếm, ví dụ chỉ index những dòng
status = 'PENDING').
2. Vô tình vô hiệu hóa Index bằng hàm hoặc phép tính
B-Tree Index lưu trữ giá trị gốc của cột. Nếu bạn bọc cột đó trong một hàm hoặc biểu thức toán học, Database Engine sẽ không thể tra cứu trên cây nhị phân được nữa.
- Lỗi 1: Dùng hàm trên cột
SQL

-- Vô hiệu hóa Index trên cột created_at:
SELECT * FROM orders WHERE DATE(created_at) = '2026-09-17';

-- Tận dụng được Index (giữ nguyên cột trần):
SELECT * FROM orders
WHERE created_at >= '2026-09-17 00:00:00'
AND created_at < '2026-09-18 00:00:00';- Lỗi 2: Tìm kiếm chuỗi với ký tự đại diện ở đầu (
%)
SQL

-- Bắt buộc Full Scan vì B-Tree chỉ sắp xếp từ trái qua phải:
SELECT * FROM users WHERE email LIKE '%@gmail.com';

-- Tận dụng được Index:
SELECT * FROM users WHERE email LIKE 'admin%';- Lỗi 3: Ép kiểu ngầm (Implicit Type Casting)
Cột phone_number lưu dạng VARCHAR, nhưng khi query bạn lại truyền vào số nguyên: WHERE phone_number = 0912345678. Database sẽ tự động bọc hàm convert kiểu dữ liệu lên cột, làm hỏng hoàn toàn Index.
3. Gánh nặng chi phí ghi (Write Penalty)
Nhiều người quên rằng Index là một cấu trúc dữ liệu phụ trợ phải tồn tại song song với bảng dữ liệu thật.
- Mỗi lệnh
INSERT,UPDATE,DELETE: Database không chỉ ghi dữ liệu vào bảng, mà còn phải tái cân bằng lại toàn bộ cây B-Tree của từng index liên quan. - Một bảng có 10 chỉ mục (index) đồng nghĩa với việc mỗi thao tác thêm 1 dòng dữ liệu mới, database phải thực hiện 11 thao tác ghi đĩa.
- Hệ quả: Bảng càng nhiều index, tốc độ
INSERTvàUPDATEcàng tụt dốc thê thảm, đồng thời gây phân mảnh trang dữ liệu (Page Splitting) và ngốn dung lượng RAM/Buffer Pool.
Quy tắc bỏ túi trước khi tạo Index
| Trường hợp | Có nên đánh B-Tree Index? | Ghi chú tối ưu |
Cột khóa ngoại (user_id, order_id) | CÓ | Hỗ trợ JOIN cực nhanh |
Cột có độ lọc cao (uuid, email) | CÓ | B-Tree phát huy sức mạnh tối đa |
Cột trạng thái nhị phân (is_active) | KHÔNG | Nên cân nhắc Partial Index nếu cần thiết |
| Bảng có tần suất GHI áp đảo ĐỌC (Log, Event) | HẠN CHẾ | Càng ít index càng tốt để bảo toàn throughput ghi |
Index giống như phụ lục tra cứu ở cuối một cuốn sách: một phụ lục chuẩn xác sẽ giúp bạn lật đúng trang cần đọc trong 1 giây, nhưng nếu trang nào cũng bị đưa vào phụ lục, cuốn sách sẽ dày gấp đôi và mất thời gian tra cứu hơn cả đọc lướt. Luôn chạy EXPLAIN ANALYZE trước và sau khi đánh index để chứng minh giá trị thực tế của nó.